반도체 Process 데이터 분석을 통한 수율 관리 방안 도출 프로젝트 (SECOM)
Kaggle의 실제 반도체 제조 Process(SECOM) 데이터를 분석해 정상·불량 그룹의 센서 분포를 비교한 프로젝트로, Random Forest의 Feature Importance로 모델의 불량 판별에서 중요도가 높은 센서 변수를 도출해 우선 모니터링 대상으로 제안했습니다.
개요
반도체 기업에서 수율 엔지니어에게는 데이터 분석 역량이 필수적이라고 생각했습니다. Pandas와 머신러닝을 학습하는 데 그치지 않고, 실제 반도체 제조 Process 데이터를 활용해 수율 저하의 원인을 분석하는 프로젝트를 진행했습니다.
문제 정의
- 590개의 Process 변수 중 수율(Pass/Fail)에 실질적인 영향을 주는 변수를 특정해야 했음
- 591개 변수(590개 Process 변수 + Pass/Fail) 중 538개 변수에 결측치가 포함되어 있어 그대로 분석에 사용할 수 없었음
- 단순 상관관계만으로는 다변량 Process 데이터에서 핵심 원인을 짚어내기 어려웠음
접근 방법
전처리
- Pandas를 활용해 결측치 비율 20%를 초과하는 32개 변수를 제거(591개 → 559개) — 20%는 데이터 정제에서 흔히 쓰는 관행적 컷오프를 기준으로 삼음. 실제로 제거된 32개 변수는 결측 비율 평균 66%(45~91% 범위)인 반면 남은 변수들은 결측이 있어도 평균 1.1%(최대 17.4%)로 두 그룹 사이 격차가 뚜렷해 20% 기준이 자연스러운 경계선이었음
- 남은 559개 변수의 결측치는 각 변수의 평균값으로 대체(fillna) — 결측치가 있는 행을 그대로 삭제했다면 전체 1,567행 중 590개 변수 모두 결측이 없는 완전한 행이 하나도 없어 데이터가 전부 소실됐을 것이고, 32개 변수 제거 후에도 완전한 행은 978개(62%)뿐이며 특히 희귀한 불량(Fail) 104건 중 67건만 남아 소수 클래스 손실이 컸을 것이므로, 행 삭제 대신 평균 대체를 택함
분석
- 정상/불량(Pass/Fail) 그룹 간 데이터 분포 비교
- Random Forest 모델을 활용해 불량 판별에서 중요도가 높은 핵심 변수(Feature Importance) Top 5 도출
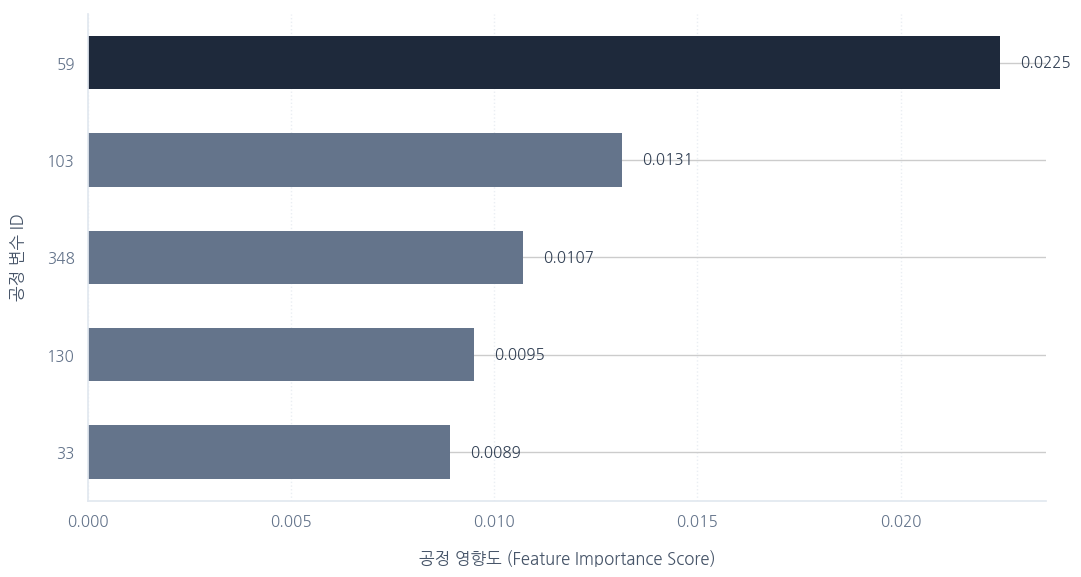
참고 : Feature Importance 수치 0.0225는 전체 변수 개수 대비 상대적으로 보면, 균등 분배 시 평균(1/558≈0.0018)의 약 12.5배로 변수 규모를 고려하면 뚜렷한 신호로 해석 가능하다고 한다.
결과 및 기여
분석 결과, 변수 59가 Importance 0.0225로 가장 높은 중요도를 보여 2위 변수(103, 0.0131)보다 뚜렷하게 앞섰습니다. 이를 바탕으로 변수 59를 우선 모니터링 대상으로 제안했습니다.
한 줄 소개
"제조 Process 데이터(SECOM)를 활용, Pandas 기반의 데이터 전처리 및 머신러닝(Random Forest)을 통해 수율 저하의 핵심 원인(Process 변수)을 규명하고 개선 방안을 도출한 프로젝트"
배운 점 & 향후 계획
- 결측치를 처리하고, 머신러닝 모델로 핵심 불량 원인을 특정하며, Process 개선점을 도출하는 엔지니어의 기본적인 문제 해결 전 과정을 경험함
- 단일 변수 상관관계가 아닌 모델 기반 변수 중요도로 접근해야 다변량 Process 데이터의 원인을 더 신뢰성 있게 짚어낼 수 있음을 체득
- 다음에는 XGBoost·LightGBM 등 다른 분류 모델과 성능을 비교하고, 도출한 핵심 변수를 실제 Process 관리도(SPC)와 연동해 실시간 이상 탐지로 확장해보고 싶습니다